Anthropic presenta dos versiones de Claude 5.2 con distinto nivel de restricciones
Anthropic ha lanzado dos variantes de su modelo de inteligencia artificial, Claude Fable 5.2 y Claude Mythos 5.2, dirigidas a usuarios que precisan funciones técnicas avanzadas, pero con distintos niveles de acceso y limitaciones.
Características y diferencias de los modelos
Ambas versiones se basan en el mismo núcleo y, según la empresa, superan a sus predecesoras en programación, razonamiento y procesamiento de imágenes, además de ofrecer respuestas hasta un 30 % más veloces. La divergencia principal radica en los controles de seguridad incorporados. Fable 5.2 contiene filtros que impiden ciertas acciones de alto riesgo en ciberseguridad, como la creación de código destinado a explotar vulnerabilidades, y gran parte de las actividades vinculadas a la investigación biológica. Mythos 5.2, por su parte, emplea el mismo modelo sin esas limitaciones, pensado para que usuarios verificados operen en esos campos, aunque no brinda la posibilidad de ejecutar cualquier tarea ni representa una inteligencia superior en términos generales.
Condiciones de acceso y precios
Fable 5.2 está disponible para el público en general, pero su uso no es gratuito. Anthropic lo ofrece a través de sus propias plataformas y mediante proveedores como Amazon Web Services, Google Cloud y Microsoft Azure. En la API de Claude, la tarifa corresponde a ocho dólares por cada millón de tokens de entrada y 40 dólares por cada millón de tokens de salida; el modelo no está incluido en la opción Free. La compañía ha comunicado la existencia de condiciones especiales temporales para algunos suscriptores de pago.
Mythos 5.2 exige un proceso de verificación que deben superar profesionales y organizaciones que trabajen en áreas como la detección de vulnerabilidades informáticas o la investigación biomédica. La solicitud se gestiona mediante los programas Cyber Verification y Life Sciences Verification, sin garantía de aceptación. Los clientes de Claude Enterprise pueden acceder a Claude Security, una herramienta que integra Mythos para el análisis de código, aunque no otorga acceso libre al modelo.
Pruebas y evaluaciones de rendimiento
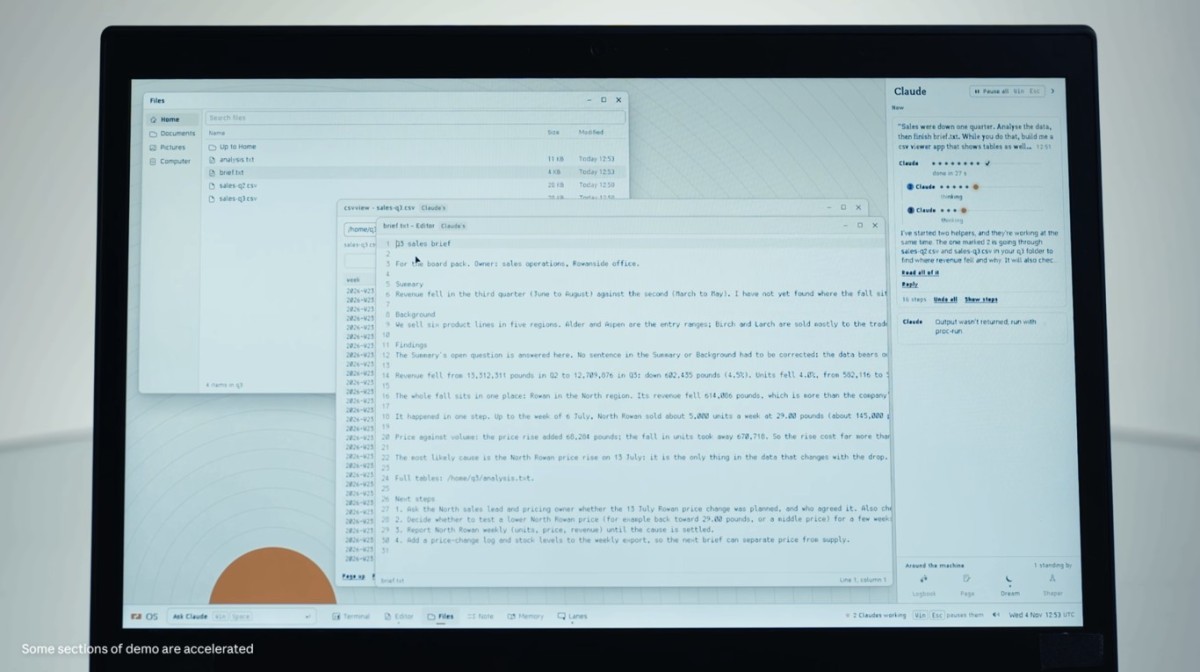
Anthropic ha demostrado la capacidad de Fable 5.2 en un experimento donde el modelo dirigió a más de 1 000 subagentes durante ocho días para construir un prototipo de sistema operativo que, según la compañía, puede iniciarse en un portátil. Asimismo, se le atribuye la solución de dos problemas abiertos de física teórica relacionados con los agujeros negros; los hallazgos aparecen en dos prepublicaciones científicas, aunque aún no han sido sometidos a revisión por pares.
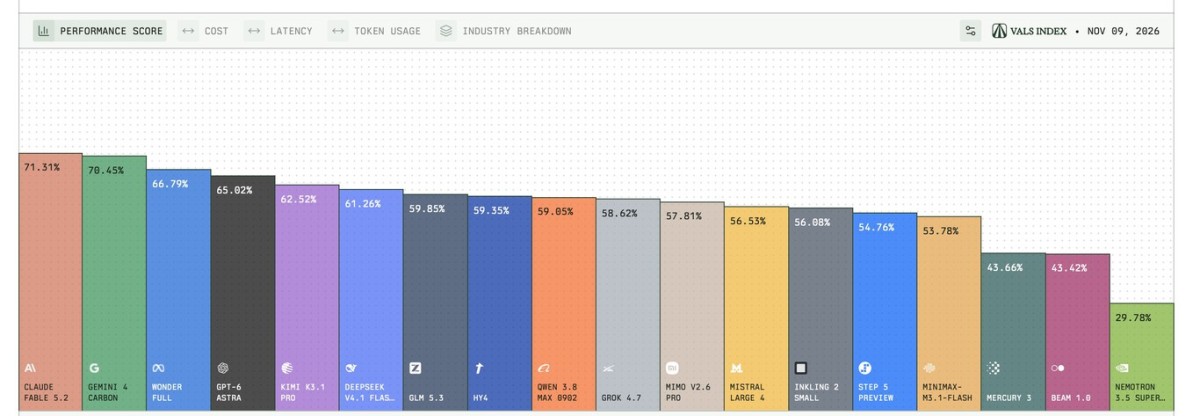
En pruebas independientes, Vals AI ubicó a Fable 5.2 en la primera posición entre 36 modelos en su índice v2.2, con un 71,31 %. Le siguen Claude Sonnet 5.5 (70,85 %) y Gemini 4 Carbon (70,45 %). Ese índice combina pruebas profesionales de programación, finanzas, derecho y fiscalidad, ponderadas según su peso en la economía de EE. UU. Las variaciones son mínimas, de modo que el primer puesto no constituye una evidencia de superioridad concluyente.
Enfoque de seguridad y limitaciones
El despliegue pone de relieve la decisión de Anthropic de ofrecer distintas modalidades de uso para una misma tecnología, basándose en los riesgos que la empresa asocia a ciertas aplicaciones. La compañía reconoce que las evaluaciones de seguridad realizadas antes del lanzamiento no pueden prever todos los posibles fallos. Por ello, la efectividad de las barreras implementadas y su capacidad para impedir usos nocivos sin entorpecer trabajos legítimos sigue pendiente de verificación.
Por qué importa
Para desarrolladores y profesionales en España que requieran IA de alto nivel para programación, investigación o ciberseguridad, la existencia de dos versiones con diferentes grados de restricción brinda alternativas que pueden ajustarse a sus requerimientos y presupuestos. No obstante, la necesidad de superar procesos de verificación y los costos asociados podrían restringir el acceso a usuarios que no cumplan los criterios establecidos por Anthropic.
Fuente: Xataka. Este artículo es una elaboración propia de TecnoPunta a partir de la información publicada.
Te puede interesar
OpenAI pone a prueba GPT‑6 Cyber, su nuevo modelo crítico para seguridad informática
OpenAI ofrece a clientes selectos el modelo GPT‑6 Cyber, una IA crítica que ha detectado cientos de vulnerabil…
Tencent presenta Hy4, su nuevo modelo de IA con visión artificial y soporte para Blender, pero sin datos ofensivos de ciberseguridad
Tencent lanza Hy4, IA con visión artificial y capacidad de usar Blender, pero sin datos ofensivos de cibersegu…
Solo cuatro viajes y 500 pedidos de Uber se realizaron mediante agentes de IA en la semana de Halloween
En la semana de Halloween Uber registró 320 millones de operaciones, pero apenas cuatro viajes y 500 pedidos d…
Sigue leyendo
Oppo podría suspender el Find X10 Ultra por falta de RAM, según una filtración
Una filtración indica que Oppo ha detenido temporalmente el proyecto Find X10 Ultra por escasez de RAM.
Leer →
TecnoPunta al día: las noticias clave del 9 de noviembre de 2026
Hoy, Francia denuncia un ciberataque que paralizó la refrigeración de 700 tiendas, mientras Tesla reorienta su planta de Texas de Cybertruck a Cybercab…
Leer →
Francia acusa a la Guardia Revolucionaria iraní de un ciberataque que alteró la refrigeración de cientos de comercios
Un ciberataque alteró la refrigeración de unos 700 comercios en Francia, provocando pérdidas y al menos quince incendios.
Leer →
¿Qué te ha parecido?
Deja el primer comentario y comparte tu experiencia o pregunta.